KI-Beschleuniger & Compute-Server
Vollständiger Katalog chinesischer KI-Compute-Hardware: Beschleunigerkarten, Compute-Server, Supernodes und Module von Huawei Atlas, MetaX, Hygon, Biren, Moore Threads und Alibaba. Modell auswählen, technische Daten ansehen und Angebot anfordern.
Huawei Atlas
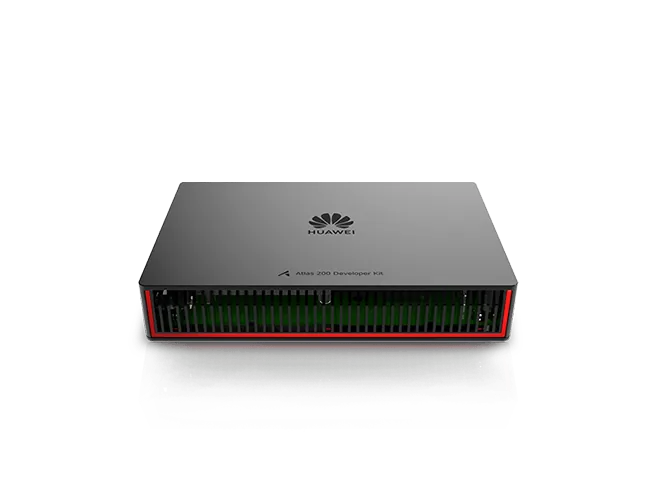
Atlas 200I DK A2 Developer Kit
Einfaches Entwicklungs-Kit für schnelle AI-Innovation Details ansehen →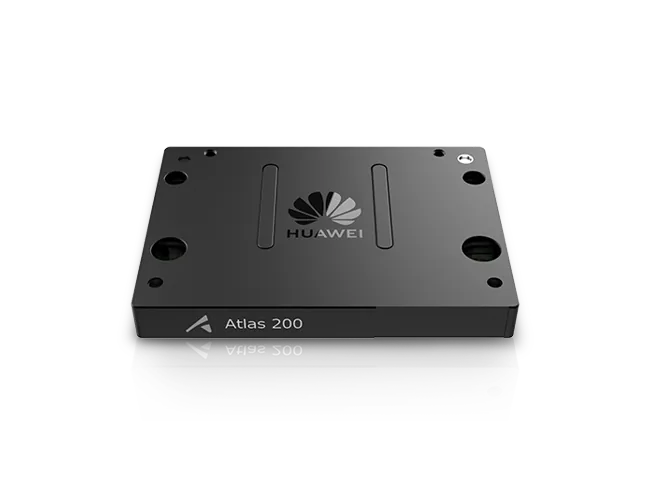
Huawei Atlas
Atlas 200I A2 Acceleration Module
In Edge-Geräte, Roboter und Drohnen eingebettetes AI-Beschleunigungsmodul Details ansehen →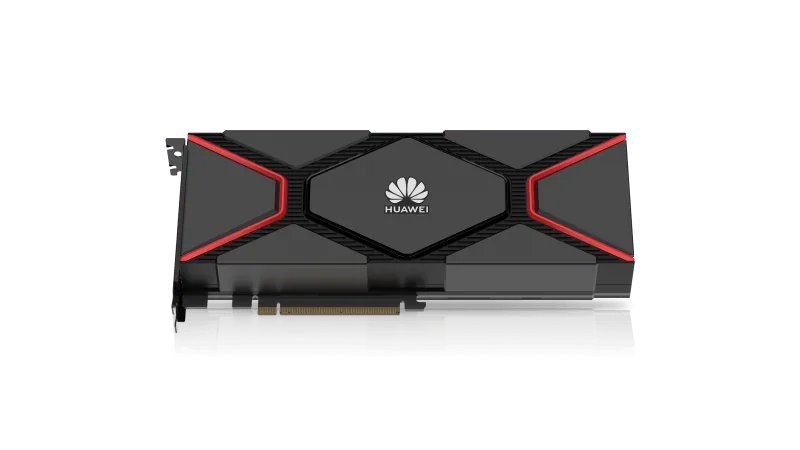
Huawei Atlas
Atlas 300I A2 Inference Card
AI-Inferenzkarte, in Server integriert, mit starker AI-Rechenleistung Details ansehen →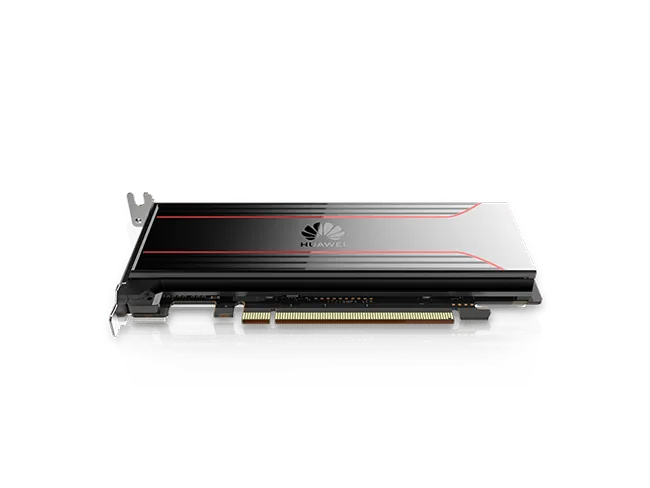
Huawei Atlas
Atlas 300I Pro Inference Card
Standard-Beschleunigerkarte für Training und Inferenz, in Server integriert, mit starker... Details ansehen →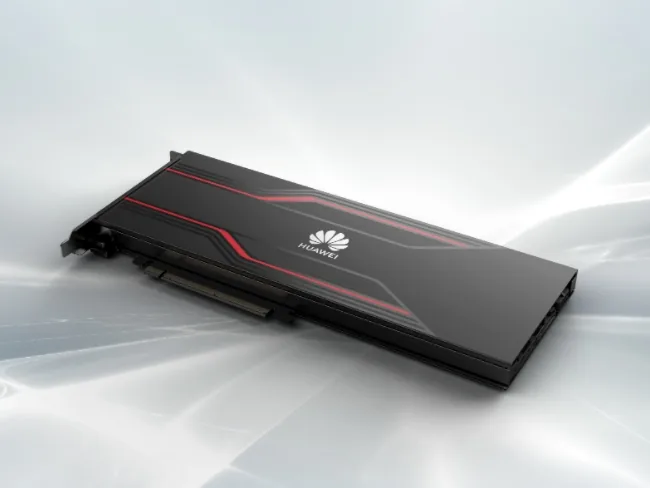
Huawei Atlas
Atlas 300I Duo Inference Card
Standard-Beschleunigerkarte für Training und Inferenz, in Server integriert, mit starker... Details ansehen →
Huawei Atlas
Atlas 300V Video Analysis Card
Standard-Beschleunigerkarte für Training und Inferenz, in Server integriert, mit starker... Details ansehen →
Huawei Atlas
Atlas 300V Pro Video Analysis Card
Standard-Beschleunigerkarte für Training und Inferenz, in Server integriert, mit starker... Details ansehen →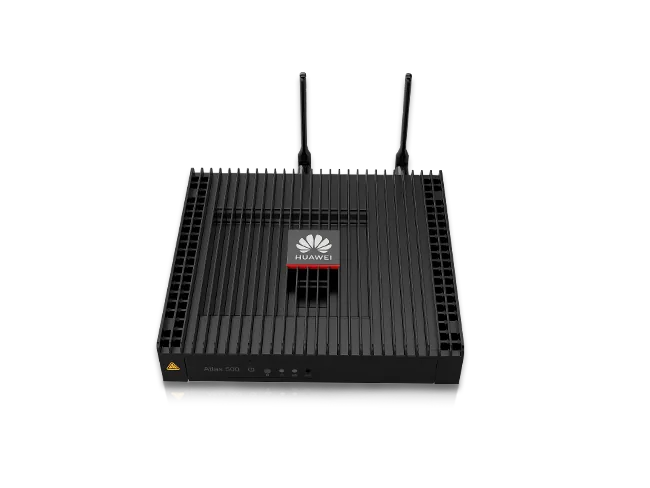
Huawei Atlas
Atlas 500 A2 Intelligent Edge Station
Lüfterlose AI-Edge-Appliance für Edge-Anwendungen, robust im Einsatz und mit... Details ansehen →
Huawei Atlas
Atlas 500 Pro Intelligent Edge Server (Model 3000)
Edge-Server mit starker Rechenleistung Details ansehen →
Huawei Atlas
Atlas 800 Inference Server (Model 3000)
AI-Server mit starker Rechenleistung Details ansehen →
Huawei Atlas
Atlas 800T A2 Training Server
AI-Server mit starker Rechenleistung Details ansehen →
Huawei Atlas
Atlas 800I A2 Inference Server
AI-Server mit starker Rechenleistung Details ansehen →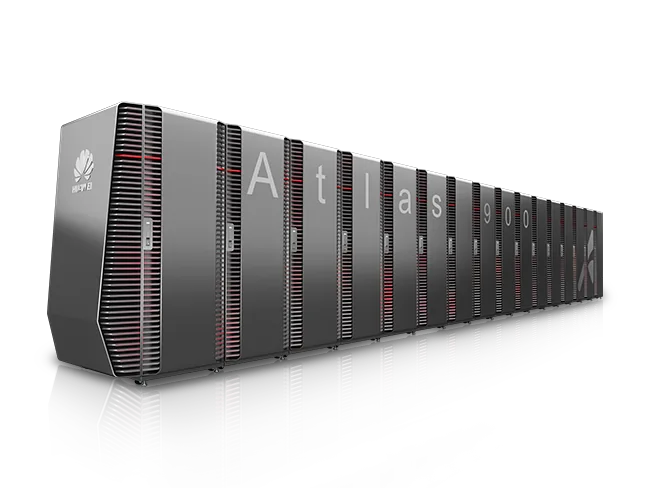
Huawei Atlas
Atlas 900 AI Cluster
Trainingscluster mit führender Leistung für AI-Rechenzentren und andere rechenintensive... Details ansehen →
Huawei Atlas
Atlas 900 A2 PoD Base Unit
Trainingscluster-Baustein mit führender Leistung für AI-Rechenzentren und andere... Details ansehen →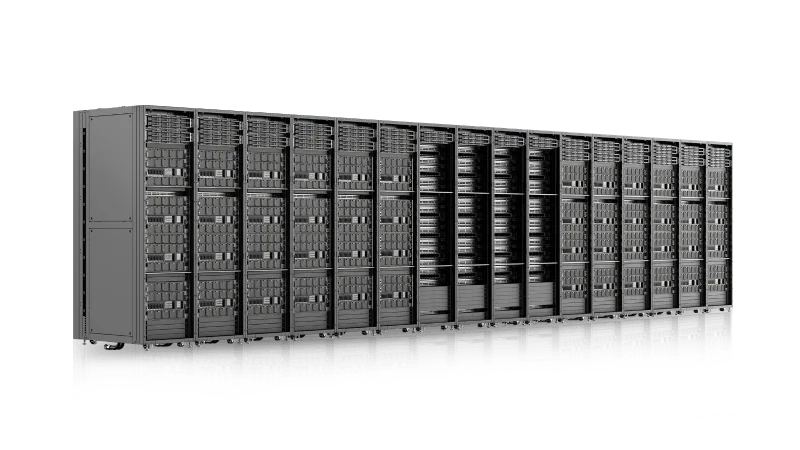
Huawei Atlas
Atlas 900 A3 SuperPoD
Hochleistungs- und hocheffizienter flüssiggekühlter Trainings-Superknoten Details ansehen →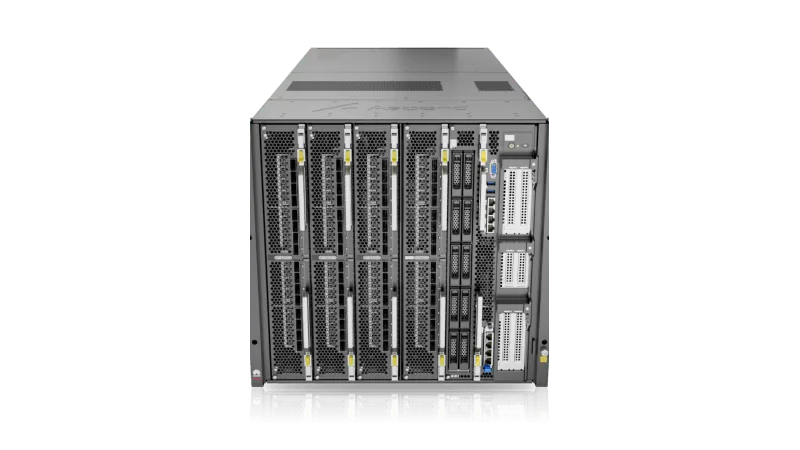
Huawei Atlas
Atlas 800T A3 Supernode Server
Hochleistungs- und hocheffizienter Trainings-Superknoten-Server (für allgemeinen... Details ansehen →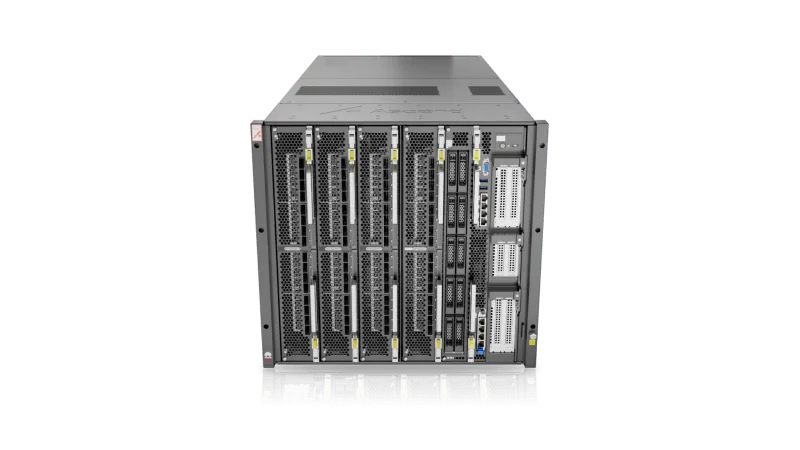
Huawei Atlas
Atlas 800I A3 Supernode Server
Hochleistungsfähiger und großskaliger luftgekühlter Inferenz-Superknoten-Server Details ansehen →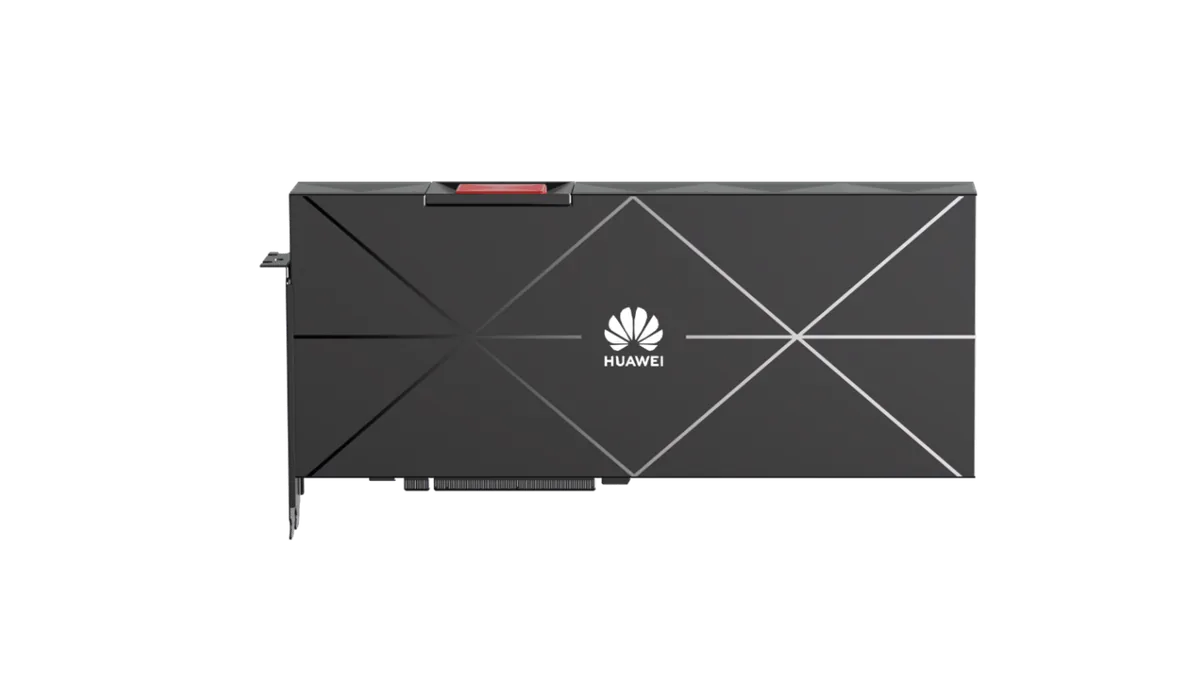
Huawei Atlas
Atlas 150
Standard-Beschleunigerkarte für Training und Inferenz, in Server integriert, mit starker... Details ansehen →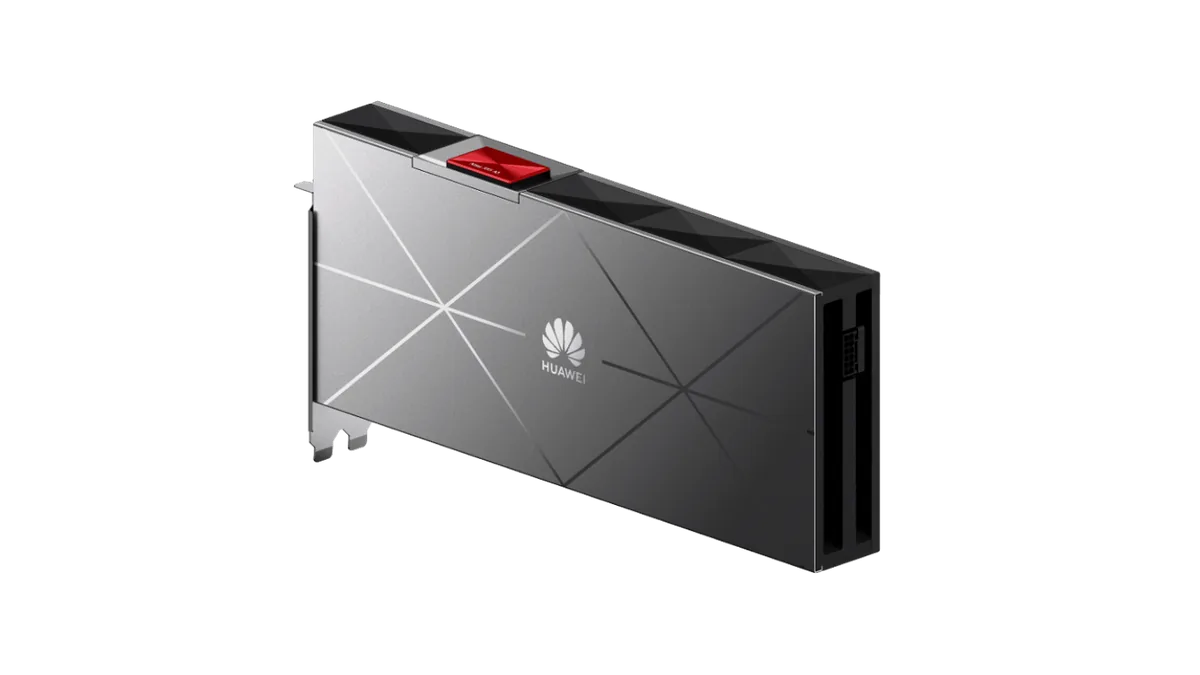
Huawei Atlas
Atlas 350
Standard-Beschleunigerkarte für Training und Inferenz, in Server integriert, mit starker... Details ansehen →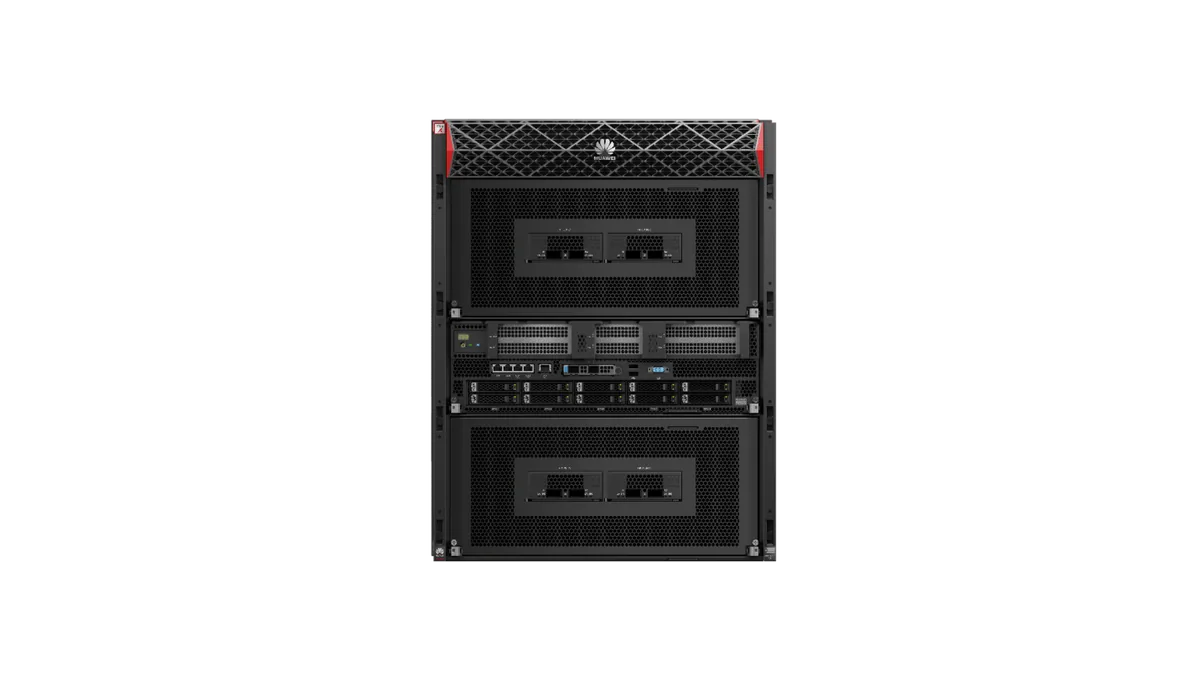
Huawei Atlas
Atlas 650E
AI-Server mit starker Rechenleistung Details ansehen →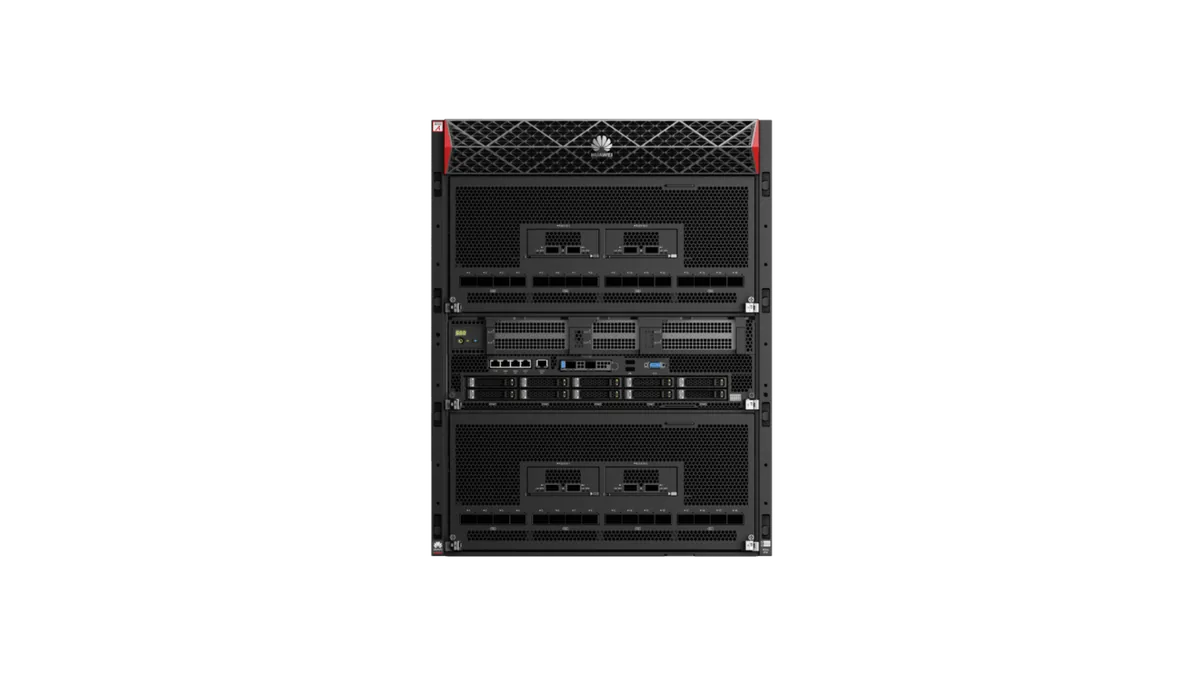
Huawei Atlas
Atlas 850E
Beste Wahl für großskalige Rechenzentren, Billionen-Modelltraining und zentrale Inferenz Details ansehen →
MetaX
N100
Intelligente Inferenz-GPU Details ansehen →
MetaX
N260
Großmodell-Inferenz-GPU Details ansehen →
MetaX
N300
Großmodell-Inferenz-GPU Details ansehen →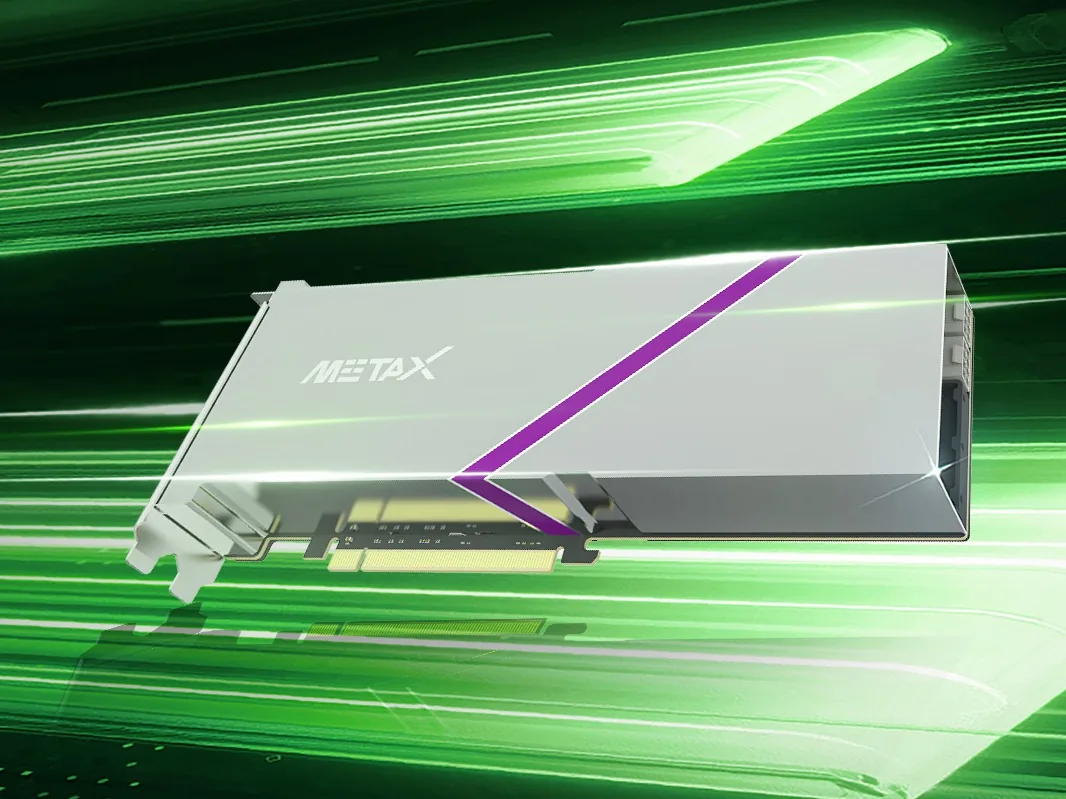
MetaX
C500
Universelle GPU (GPGPU) Details ansehen →
MetaX
C550
Universelle GPU (OAM-Modul) Details ansehen →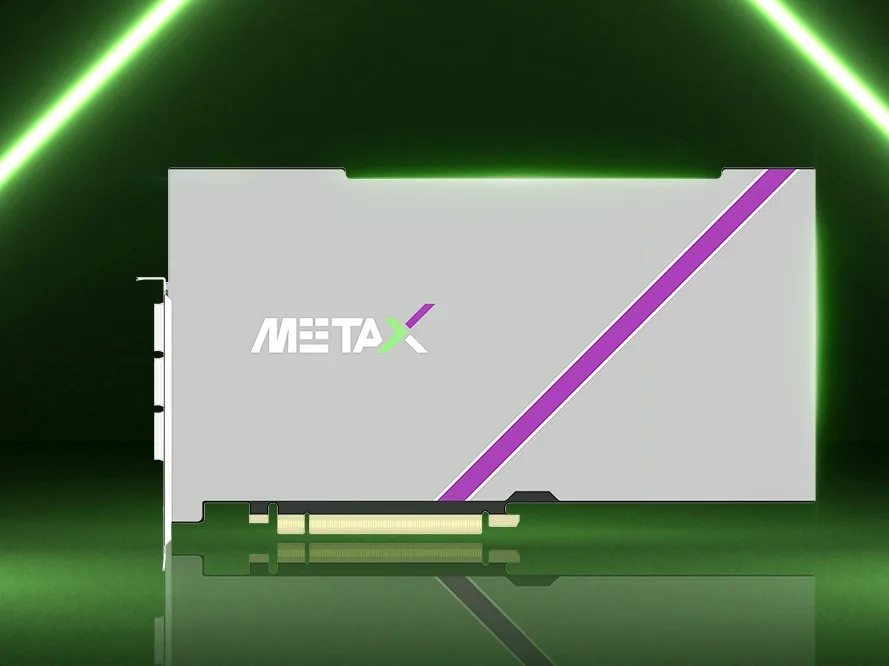
MetaX
C500X
Optisch verbundene universelle GPU Details ansehen →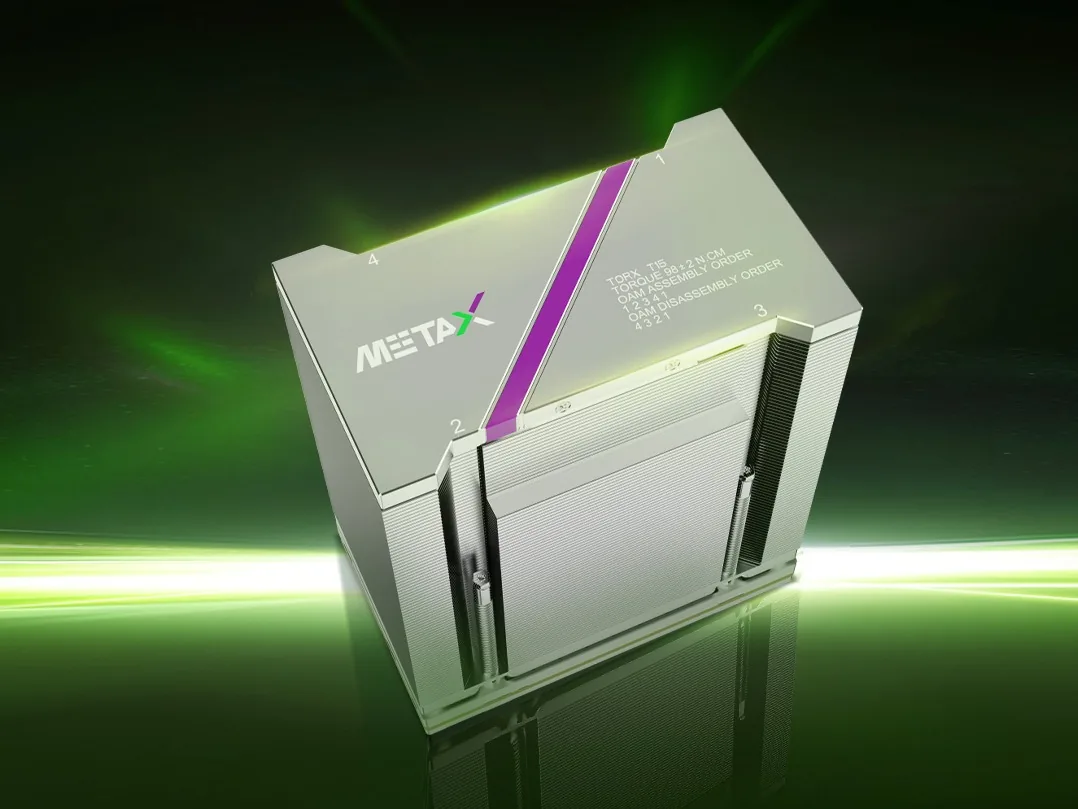
MetaX
C588
Universelle GPU (Flaggschiff-OAM-Modul) Details ansehen →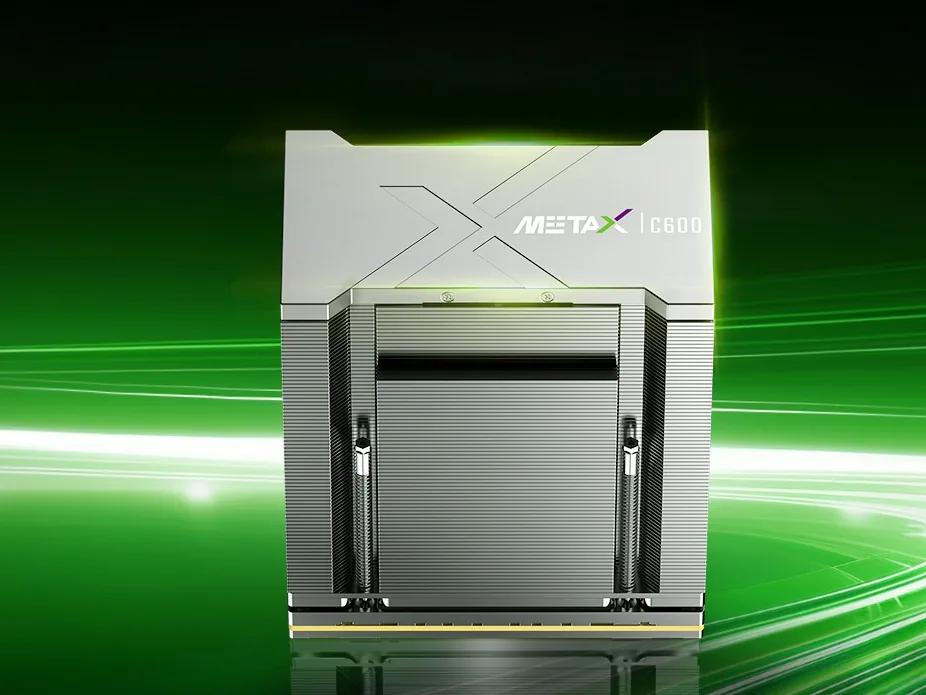
MetaX
C600
Universelle GPU (OAM-Modul, Luft-/Flüssigkühlung) Details ansehen →
MetaX
N260 Server
Standard-Rackmount-GPU-Inferenzserver Details ansehen →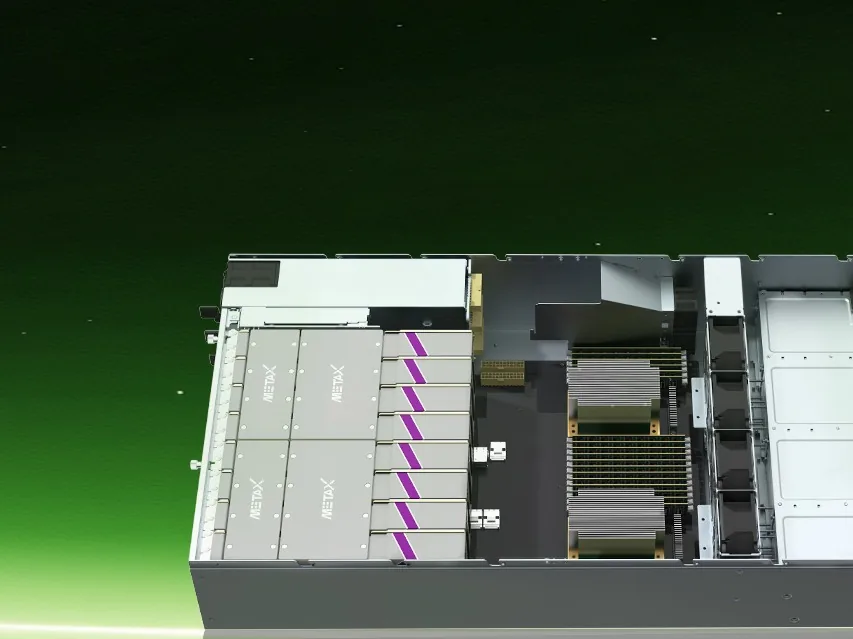
MetaX
N300 Server
Hochdichter AI-Inferenzserver mit hoher Parallelität Details ansehen →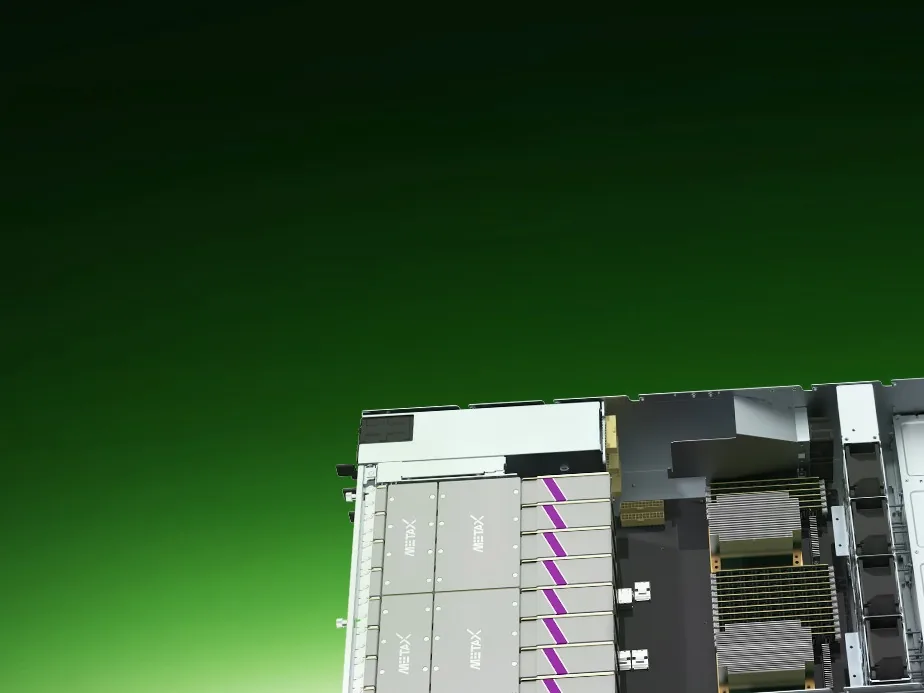
MetaX
C500 Server
Standard-Rackmount-GPU-Server Details ansehen →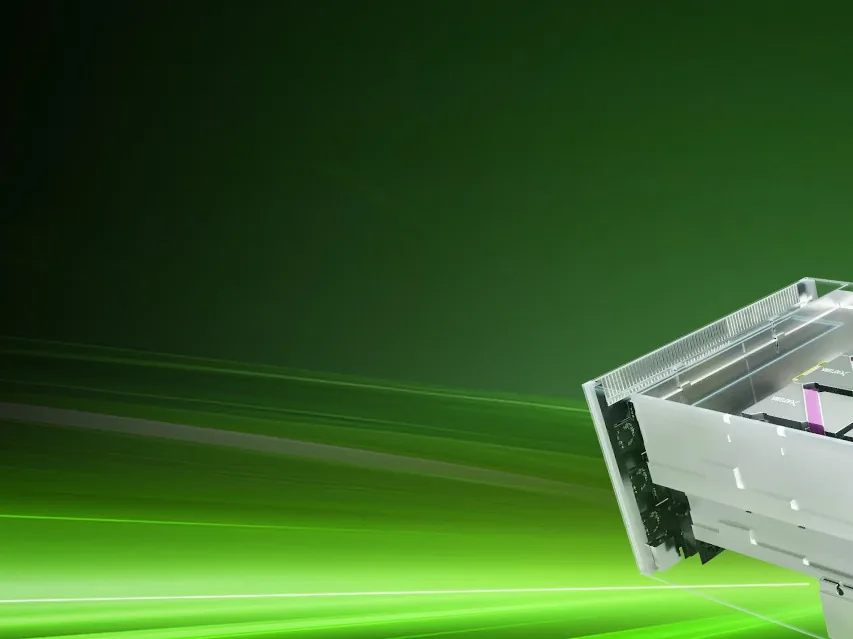
MetaX
C550 OAM Server
Flaggschiff-Dual-Socket-Standard-OAM-Server Details ansehen →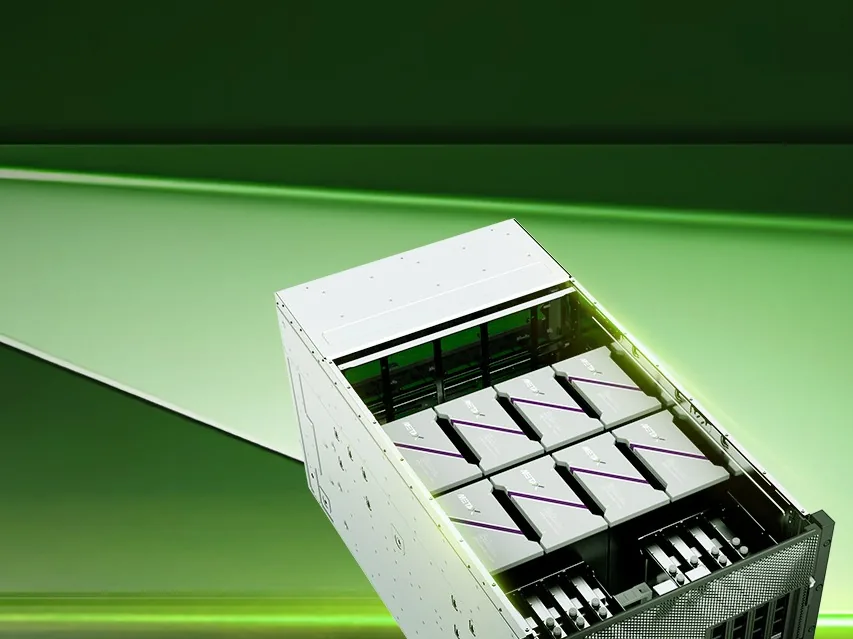
MetaX
C588 OAM Server
Flaggschiff-Dual-Socket-Standard-OAM-Server (Luft-/Flüssigkühlung konvergent) Details ansehen →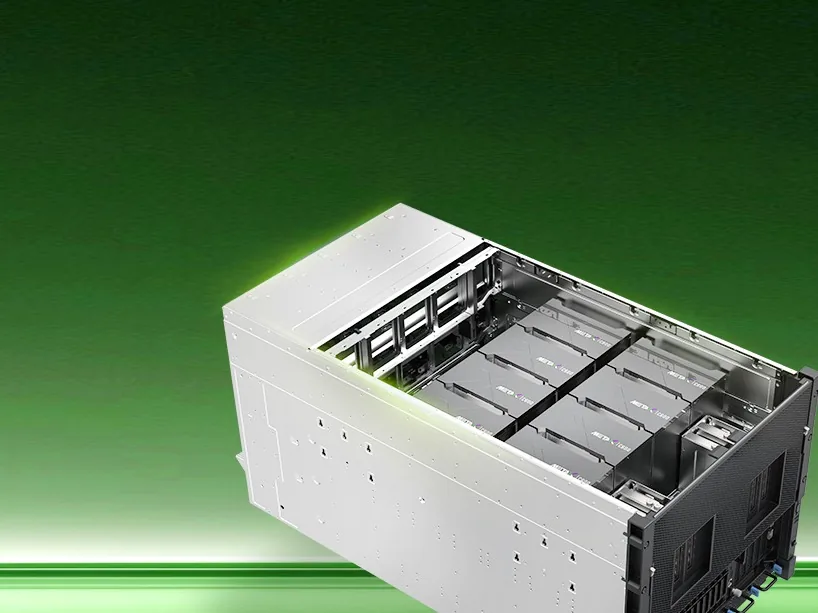
MetaX
C600 OAM Server
Flaggschiff-Dual-Socket-Standard-OAM-Server Details ansehen →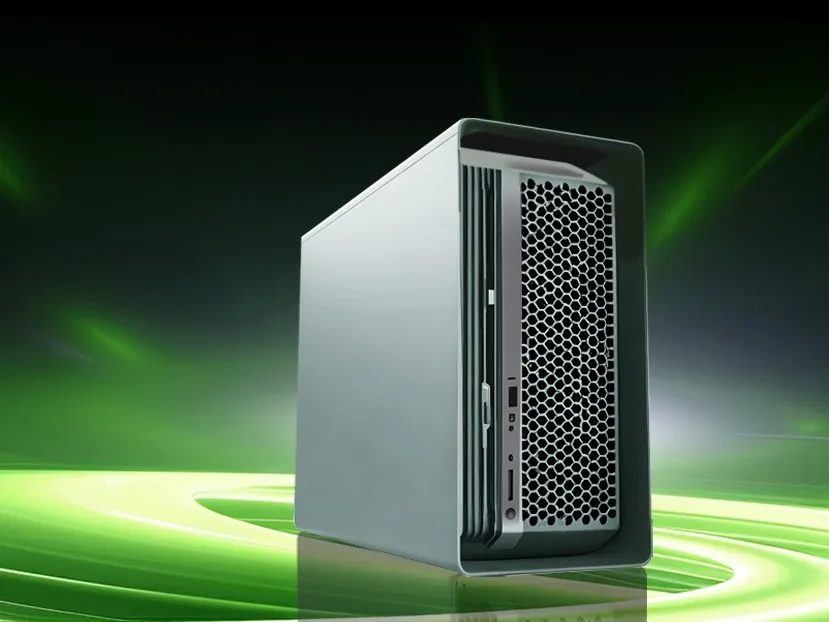
MetaX
N260 Workstation
Aktiv gekühlte GPU-Workstation (nicht für Rechenzentren) Details ansehen →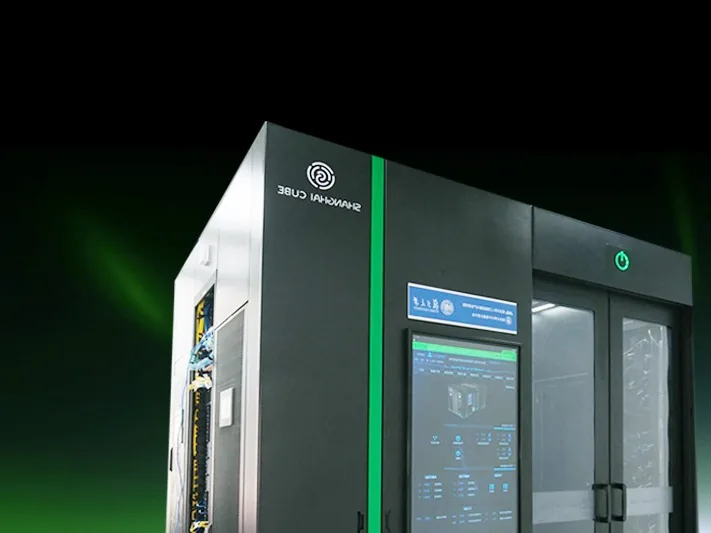
MetaX
C550 Shanghai Cube Liquid-Cooled Cabinet
Hochdichter flüssiggekühlter Vollschrank (128 GPUs/Rack) Details ansehen →
MetaX
C500X Optical-Interconnect Supernode
Optisch verbundener Superknoten (bis zu 8 Server / 64 Karten) Details ansehen →
MetaX
C550 3D Mesh Supernode
Elektrischer 3D-Mesh-Superknoten (bis zu 8 Server / 64 Karten) Details ansehen →
Hygon
Hygon Deep Computing Processor DCU (specific model not disclosed)
Hochleistungs-Deep-Computing-Prozessor auf einer gängigen allgemeinen... Details ansehen →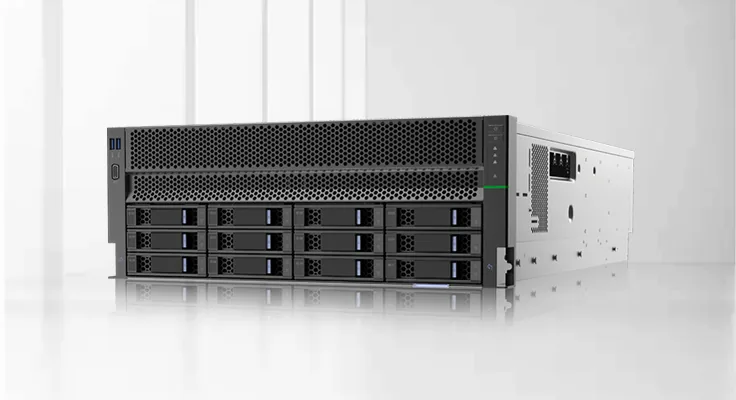
Hygon
Heterogeneous Computing Server (specific model not disclosed)
Bauform eines dedizierten Heterogen-Computing-Servers auf Hygon-Prozessorbasis Details ansehen →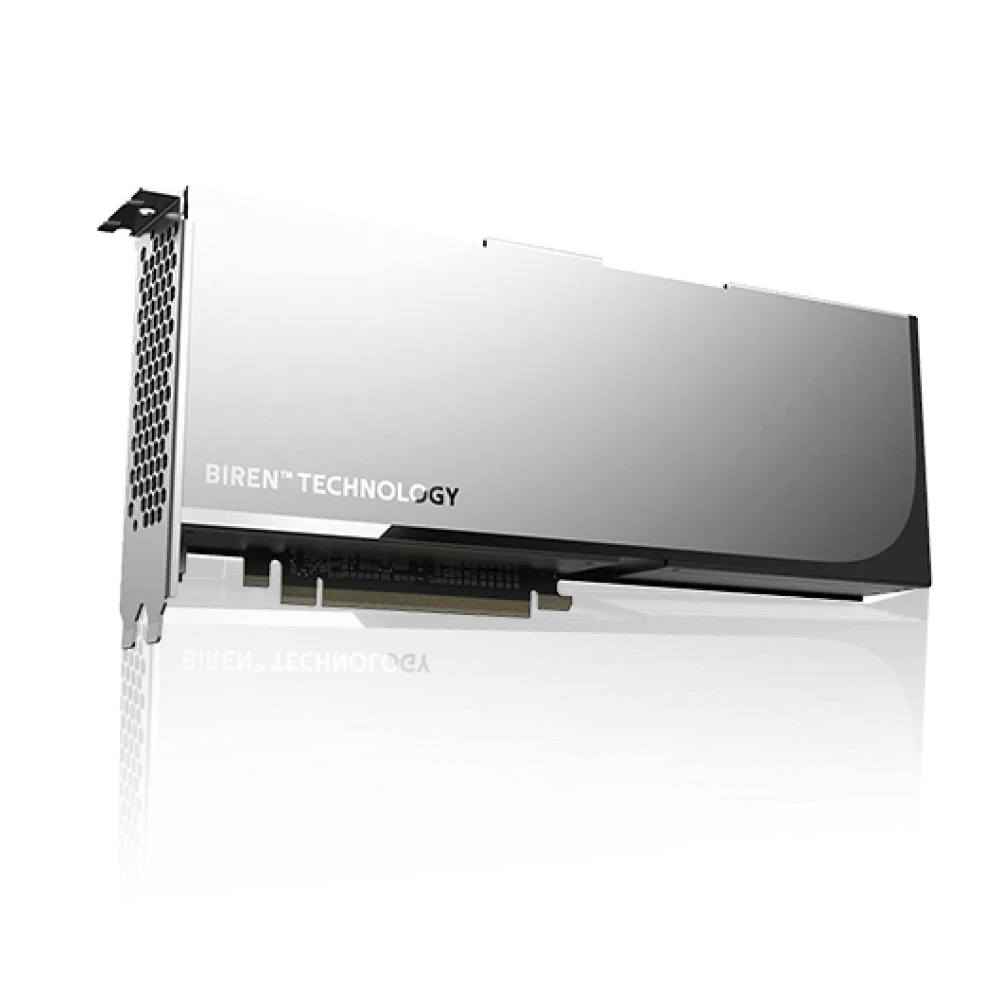
Biren
BIREN 106B
Vollhohe volllange doppelt breite PCIe-AI-Trainings-/Inferenz-Beschleunigerkarte Details ansehen →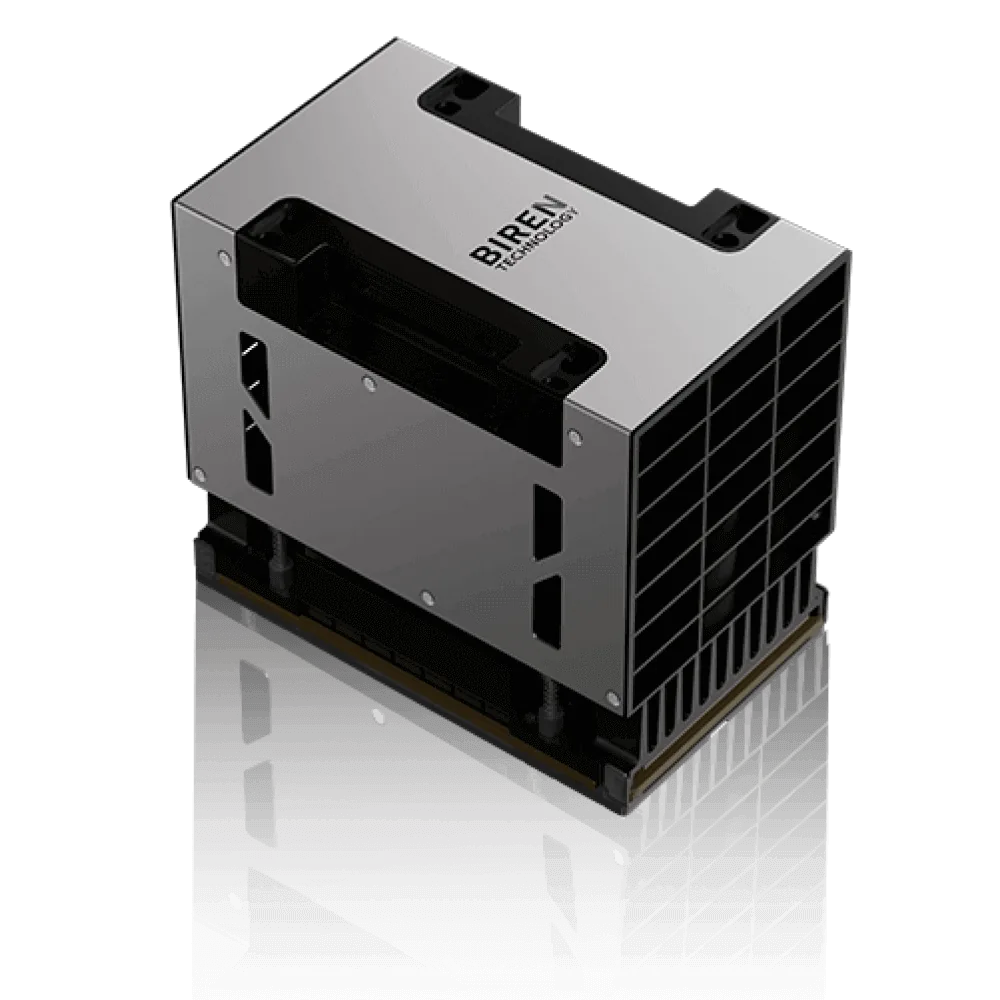
Biren
BIREN 106M
Luftgekühltes OAM-Modul als AI-Trainingsbeschleuniger Details ansehen →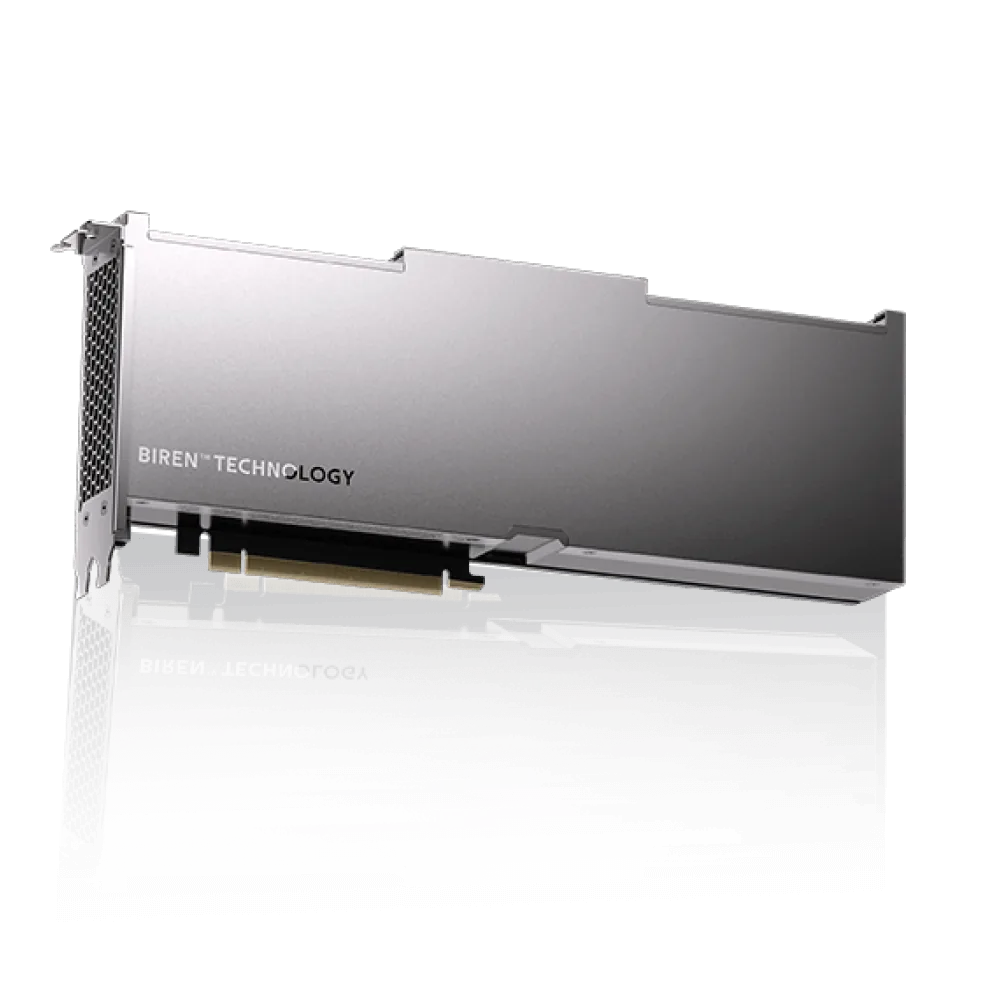
Biren
BIREN 166C
Rechenzentrums-Hochleistungs-AI-Inferenzbeschleuniger (PCIe) Details ansehen →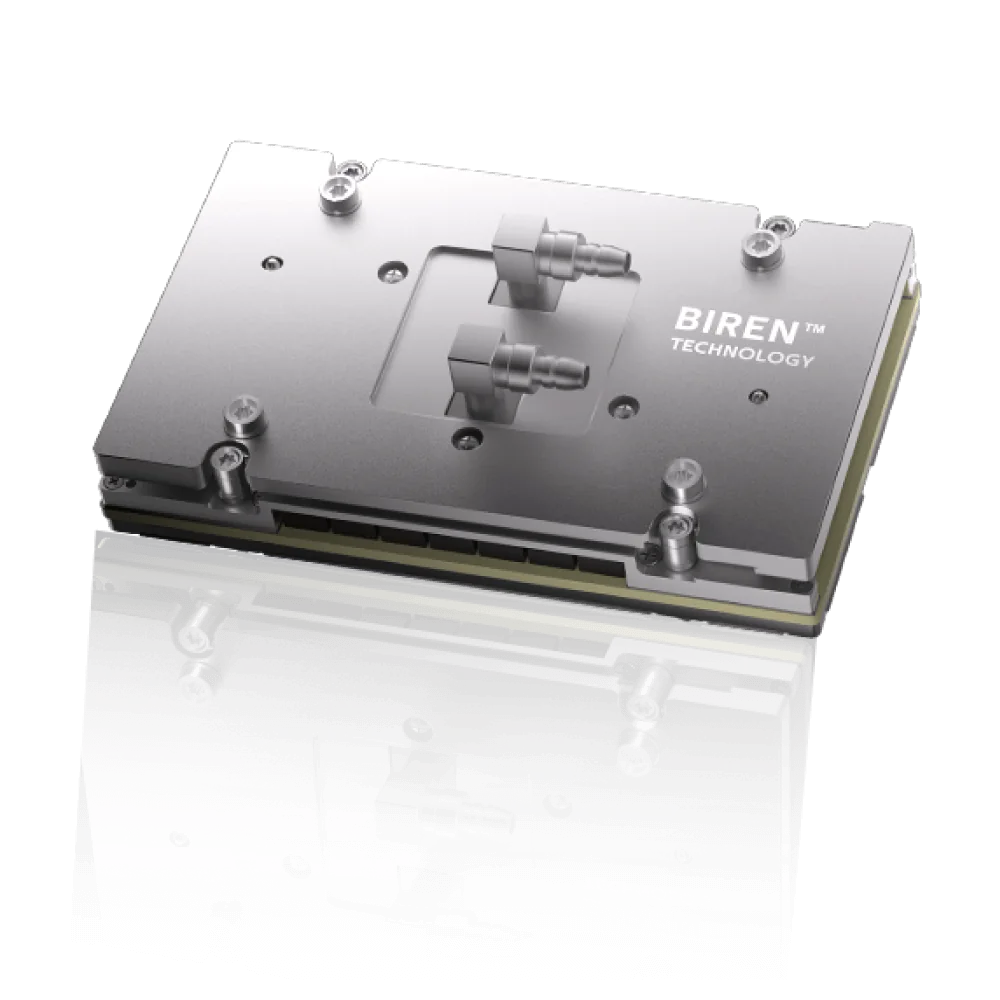
Biren
BIREN 166L
Trainings- und inferenzkonvergentes flüssiggekühltes OAM-Modul (Cold-Plate) Details ansehen →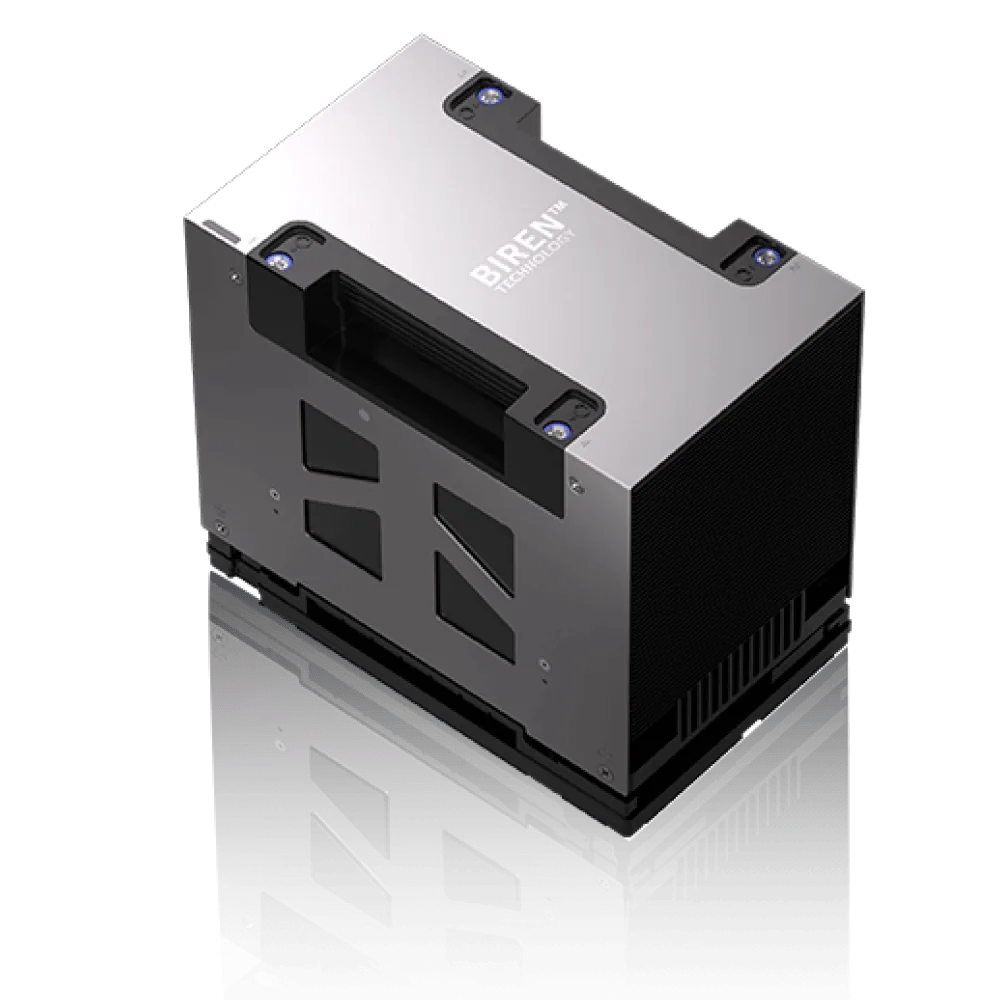
Biren
BIREN 166M
Trainings- und inferenzkonvergentes luftgekühltes OAM-Modul (OAM V1.1) Details ansehen →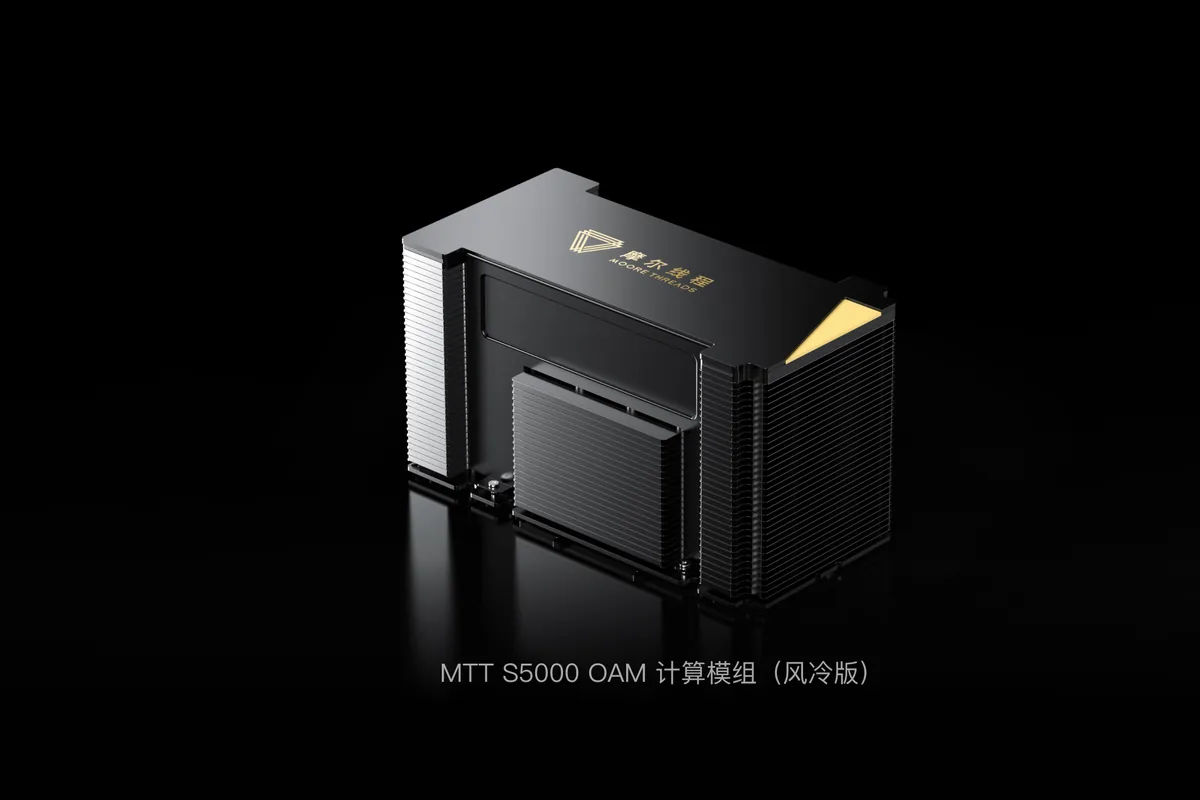
Moore Threads
MTT S5000
Allround-GPU für Training und Inferenz mit voller Funktionsausstattung Details ansehen →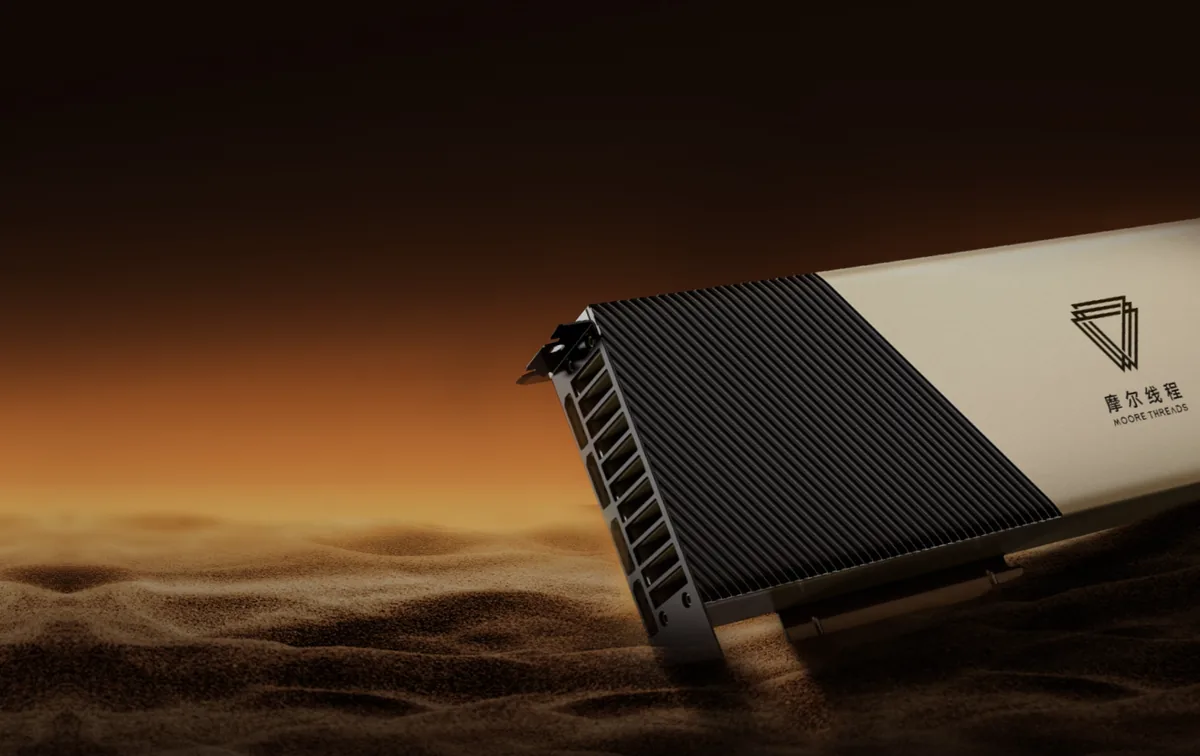
Moore Threads
MTT S4000
Großmodell-Beschleunigungskarte Details ansehen →
Moore Threads
MTT S3000
Voll ausgestattete Server-GPU Details ansehen →
Moore Threads
MTT S2000
Stromsparende voll ausgestattete Server-GPU für Cloud-Native-Szenarien Details ansehen →
Moore Threads
MTT SGX5000
Integrierter AI-Server mit Trainings- und Inferenz-GPU Details ansehen →
Moore Threads
MCCX D800 X1
Integrierter AI-Großmodell-Trainings-/Inferenzserver (8-GPU-Server) Details ansehen →
Moore Threads
MTT KUAE
Full-Stack-Lösung für intelligente Rechenzentren Details ansehen →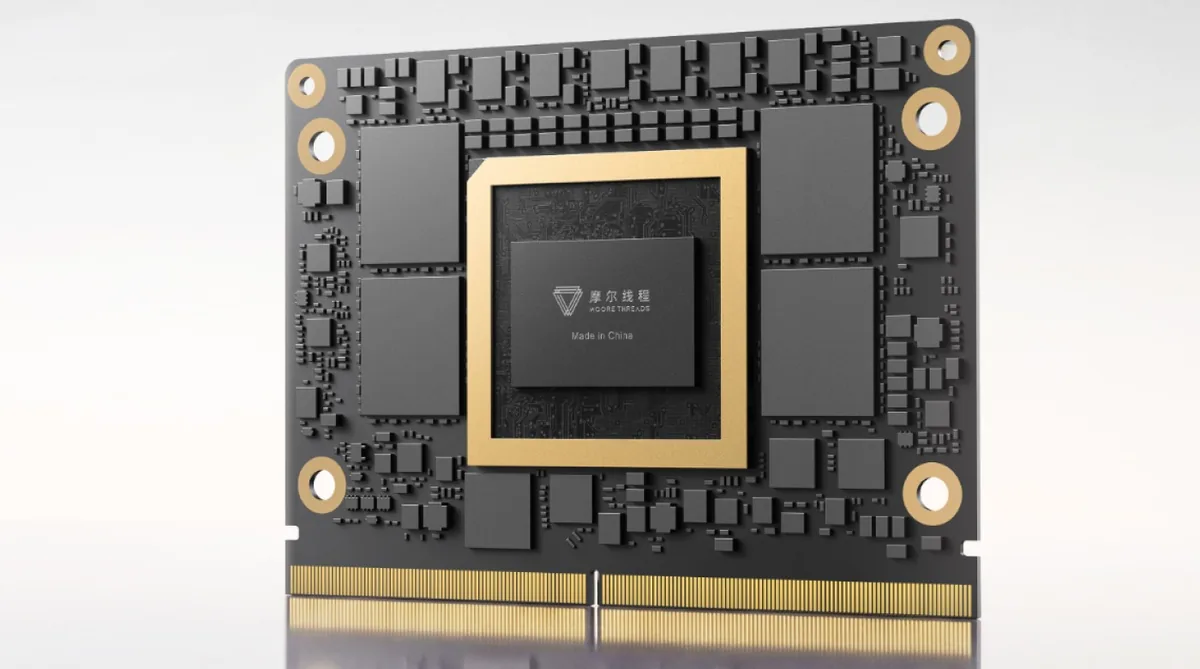
Moore Threads
MTT E300
AI-Modul speziell für eingebettete Edge-Szenarien Details ansehen →
Alibaba
Hanguang 800 NPU (AI Inference Chip)
Alibabas erster AI-Inferenzchip (NPU) für Cloud-Suche, -Empfehlung, -Werbung und... Details ansehen →
Alibaba
Zhenwu M890 All-Scenario Training & Inference AI Chip
Vollständig eigenentwickelter allzweck-Trainings- und Inferenz-AI-Chip mit... Details ansehen →
Alibaba
Zhenwu V900 Training & Inference AI Chip
Hochleistungs-Trainings- und Inferenz-AI-Chip mit 216 GB Speicher, 1200 GB/s Interconnect... Details ansehen →
Alibaba