Alibaba · Beschleunigerkarte
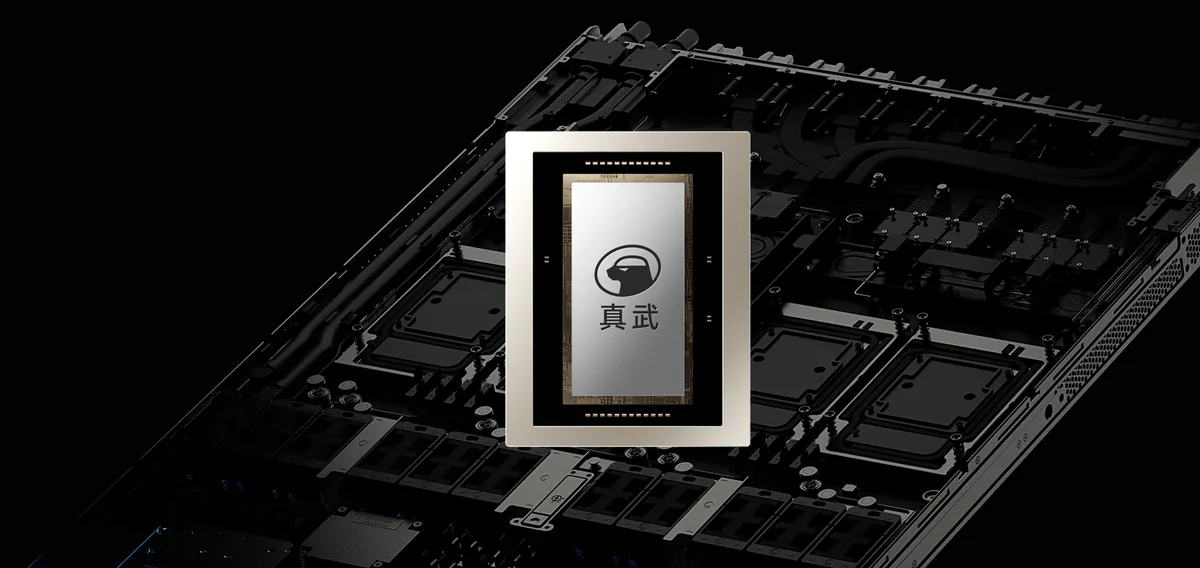
Zhenwu V900 Training & Inference AI Chip
Produkt aus dem offiziellen Bereich „AI-Chips“ von T-Head. Hardware-seitig durchgängig eigenentwickelt, mit tiefer Iteration von Parallelrechenarchitektur und Chip-zu-Chip-Interconnect. Der eigenentwickelte T-Head SAIL®-Full-Stack-Softwarestack bietet eine einheitliche Programmierschnittstelle und minimiert Codeänderungen bei der Geschäftsmigration. Er unterstützt Mehrprozess-Ressourcen-Teilen und Mandanten-sichere Isolation. Offizielle Spezifikationen: Speicher 216 GB; Chip-zu-Chip-Interconnect-Bandbreite 1200 GB/s; FP8/FP4-Instruktionspräzision optimiert und erweitert; auf Basis des...
Wichtigste Merkmale
- Hohe Leistung: 216 GB Speicher, 1200 GB/s Chip-zu-Chip-Interconnect, FP8/FP4-Erweiterung, 1024-Karten-Vollbandbreite
- ICN-Switch-Scale-Up-Domäne mit symmetrischer Bandbreite und einheitlicher Speicheradressierung
- durchgängige Präzisionsabdeckung FP32→FP4
- SAIL®-Softwarestack mit Hard- und Software-Co-Design
- flexible Bereitstellung
Technische Daten
| Speicherkapazität | 216 GB |
|---|---|
| Inter-Chip-Bandbreite | 1200 GB/s (eigenentwickelter ICN-Bus / proprietary ICN bus) |
| Niedrigpräzisions-Formate | FP8 / FP4 (inkl. MXFP8/MXFP4-Skalierungsformate / MXFP8/MXFP4 scaling) |
| Interconnect-Umfang | zwei Ebenen ICN-Switch, 1024-Chip-Scale-Up-Vollbandbreite-Domäne / 1024-chip Scale-Up fabric |
| Software-Stack | T-Head SAIL® (einheitliche API, Hard- und Software-Co-Design / unified API, co-designed) |
| Herstellungsverfahren, TDP, Bauform | nicht veröffentlicht / not disclosed |
Typische Einsatzbereiche
GroßmodelltrainingGroßmodell-InferenzTrainieren und Inferieren von Autonomes-Fahren-Modellenmultimodales Modelltraining und -inferenz
Ähnliche Produkte
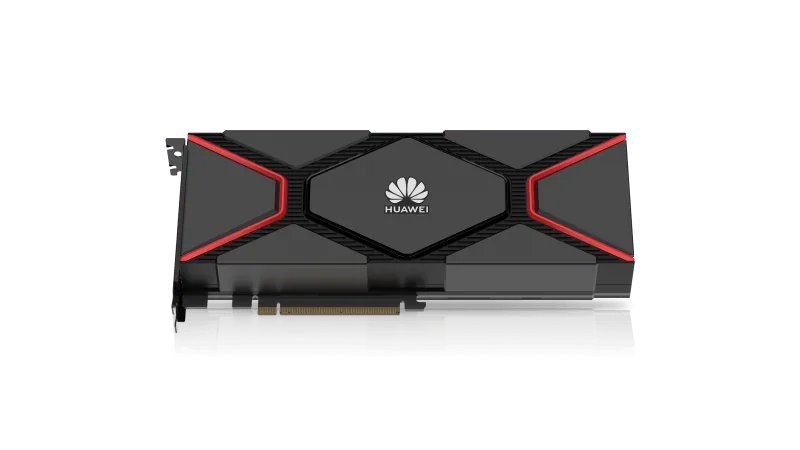
Huawei Atlas
Atlas 300I A2 Inference Card
AI-Inferenzkarte, in Server integriert, mit starker AI-Rechenleistung Details ansehen →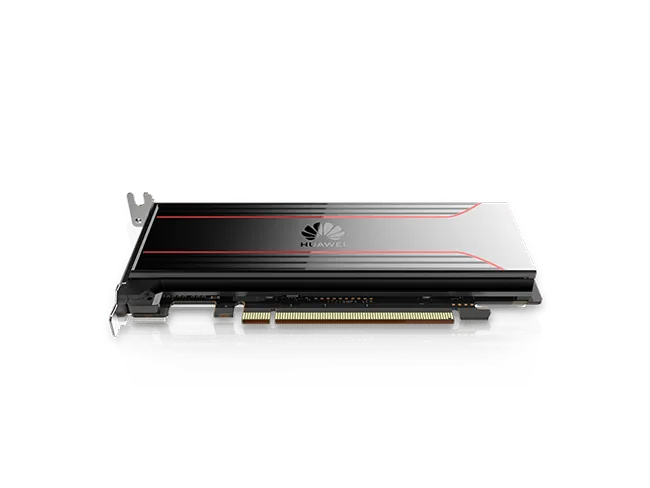
Huawei Atlas
Atlas 300I Pro Inference Card
Standard-Beschleunigerkarte für Training und Inferenz, in Server integriert, mit starker... Details ansehen →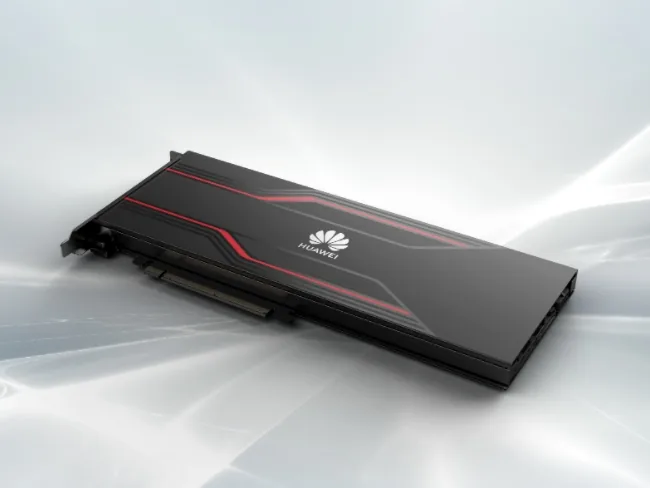
Huawei Atlas
Atlas 300I Duo Inference Card
Standard-Beschleunigerkarte für Training und Inferenz, in Server integriert, mit starker... Details ansehen →
Huawei Atlas