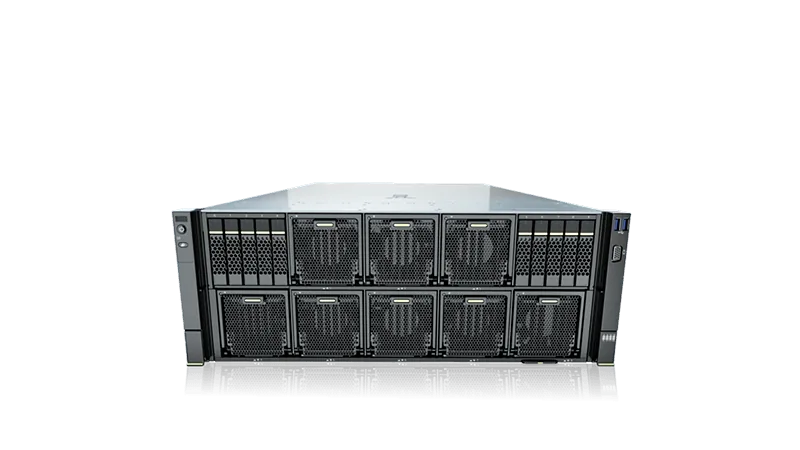
Huawei Atlas · Serveur de calcul
Atlas 800I A2 Inference Server
Le serveur d'inférence Atlas 800I A2 adopte une architecture à 8 modules pour une inférence efficace. Il offre une capacité d'inférence IA puissante, avec des avantages en puissance de calcul, bande passante mémoire et interconnexion. Il s'applique largement à l'inférence de grands modèles génératifs : service client intelligent, génération de textes, capitalisation des connaissances et autres scénarios de génération de contenu. L'interconnexion NPU améliore l'efficacité d'inférence des grands modèles.
Points clés
- Inférence efficace sur 8 modules
- Puissance de calcul, bande passante mémoire et interconnexion remarquables
- Interconnexion NPU à l'appui de l'efficacité d'inférence des grands modèles
Caractéristiques techniques
| Facteur de forme | 4U AI server |
|---|---|
| CPU | Kunpeng 920 x4 |
| Mémoire | 32x DDR4 DIMM slots up to 3200MT/s |
| Interconnexion interne | optional full NPU mesh, 392GB/s aggregate |
| Réseau externe | 8x 200GE QSFP RoCE |
| PCIe | up to 3x PCIe 4.0 |
| PSU redondante | 4x 2.6kW, 2+2 |
| Refroidissement | air-cooled |
| Modèle de module et puissance totale | non publié |
Cas d'usage typiques
Inférence de grands modèles génératifs : service client intelligent, génération de textes, capitalisation des connaissances et autres scénarios de génération de contenu.
Produits associés
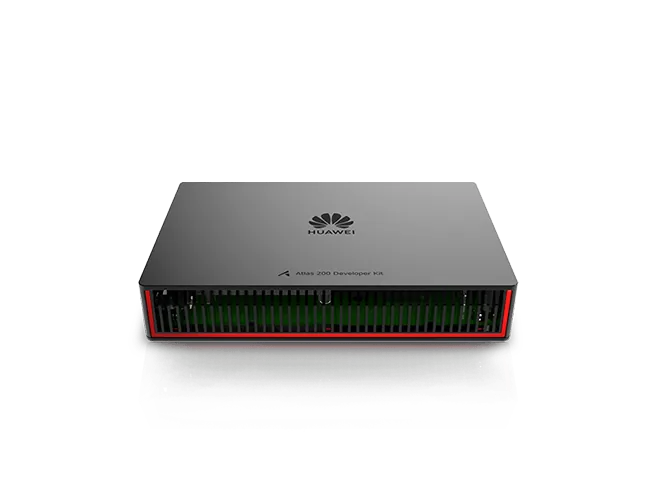
Huawei Atlas
Atlas 200I DK A2 Developer Kit
Kit de développement IA simple et prêt à l'emploi pour innover rapidement Voir les détails →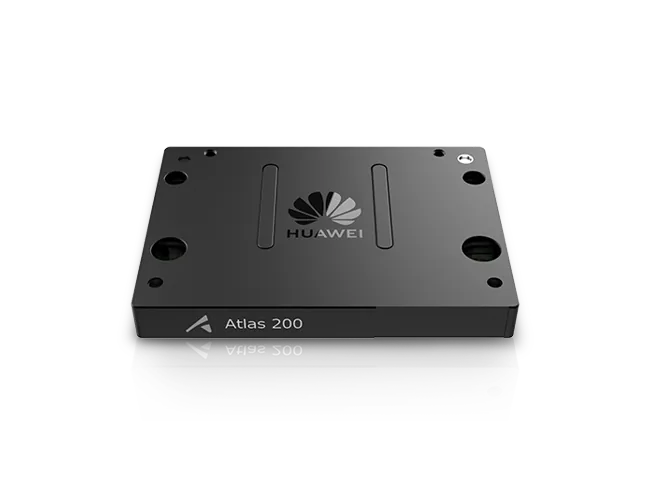
Huawei Atlas
Atlas 200I A2 Acceleration Module
Module d'accélération IA embarqué dans les dispositifs intelligents périphériques, robots... Voir les détails →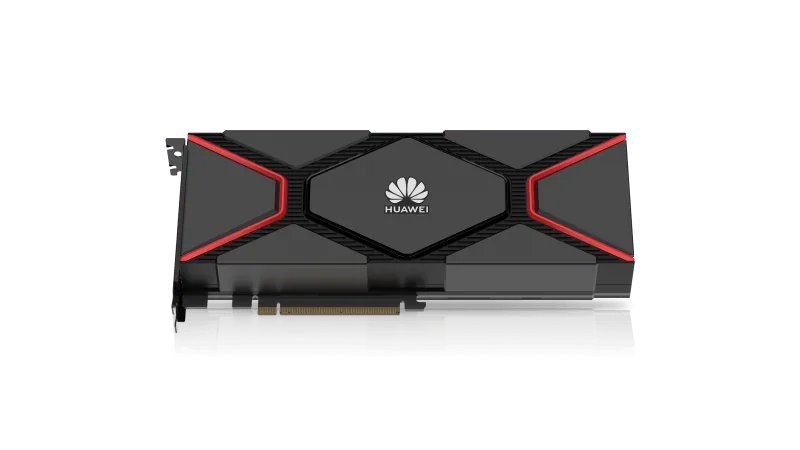
Huawei Atlas
Atlas 300I A2 Inference Card
Carte d'inférence IA intégrée aux serveurs pour une puissance de calcul exceptionnelle Voir les détails →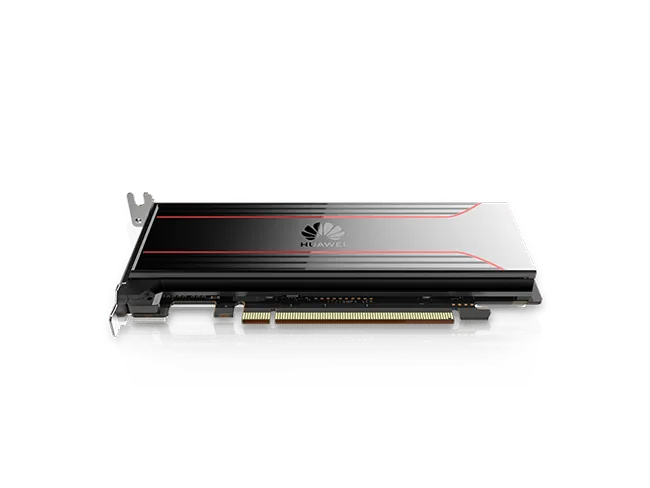
Huawei Atlas